Tips Mengoptimalkan GPU untuk AI Lokal, Cara Mempercepat Inferensi dan Menekan Beban Sistem
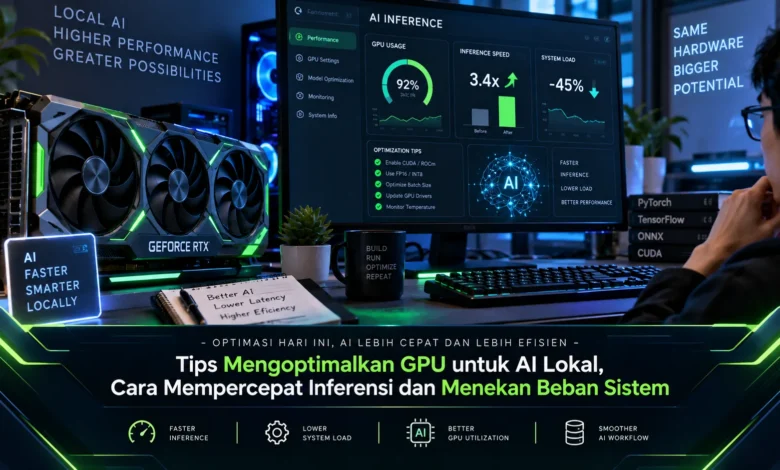
Menjalankan AI secara lokal semakin menarik karena pengguna dapat memproses model langsung melalui komputer sendiri tanpa selalu bergantung pada layanan cloud. Namun, performa AI lokal sangat dipengaruhi oleh kemampuan GPU, kapasitas VRAM, ukuran model, serta konfigurasi software yang digunakan. Dengan optimasi yang tepat, inferensi dapat berjalan lebih cepat sekaligus menjaga beban sistem tetap terkendali. Pendekatan ini semakin relevan dalam perkembangan TEKNOLOGI AI ketika model lokal mulai digunakan untuk berbagai kebutuhan produktivitas dan eksperimen.
Pahami Beban Model agar Inferensi Lokal Lebih Efisien
Langkah awal dalam mengoptimalkan GPU untuk AI lokal dimulai dengan mengenali ukuran serta kebutuhan sumber daya model. Setiap arsitektur kecerdasan buatan memiliki karakter penggunaan GPU yang berbeda, karena model dengan parameter lebih banyak tidak selalu ideal untuk perangkat lokal. Model yang sesuai dengan kapasitas perangkat biasanya dapat memberikan inferensi yang lebih stabil.
Pengguna sebaiknya memperhatikan kapasitas VRAM yang tersedia karena bobot model serta data sementara harus berada di memory ketika diproses. Ketika model menghabiskan hampir semua VRAM, workload dapat mengalami tekanan memory saat konteks maupun data bertambah. Dengan memilih ukuran model secara realistis, pengguna dapat memperoleh keseimbangan yang lebih baik antara kualitas model dan performa sistem.
Kelola VRAM agar Inferensi Tetap Cepat dan Stabil
Memory GPU menjadi salah satu komponen utama dalam proses inferensi model secara lokal. Jika sebagian besar komputasi dapat dipertahankan pada kartu grafis, pemrosesan berpotensi berlangsung lebih cepat daripada kondisi yang membutuhkan perpindahan data secara berulang ke RAM.
Menghentikan software yang mengonsumsi memory grafis secara tidak penting dapat membuat kapasitas GPU yang tersedia menjadi lebih besar. Aplikasi visual, software editing, browser, serta program lain yang memanfaatkan GPU mungkin mengambil kapasitas memory yang sebenarnya dapat digunakan model. Tidak menggunakan seluruh kapasitas VRAM sejak awal membantu menjaga stabilitas saat workload membutuhkan alokasi tambahan. Manajemen seperti ini dapat memberikan dampak nyata tanpa harus mengganti hardware.
Gunakan Quantization untuk Menekan Konsumsi VRAM
Quantization menjadi salah satu teknik yang banyak digunakan ketika ingin menekan kebutuhan sumber daya model. Quantization mengurangi jumlah bit yang diperlukan untuk menyimpan sebagian informasi model, sehingga model dapat membutuhkan kapasitas memory yang lebih kecil. Representasi bobot yang lebih ringkas berpotensi memungkinkan perangkat dengan VRAM terbatas memuat model yang sebelumnya terlalu berat.
Pemilihan tingkat quantization tetap perlu disesuaikan dengan kebutuhan. Quantization yang lebih agresif dapat membuat ukuran model semakin kecil, namun hasil inferensi tertentu mungkin mengalami penurunan kualitas. Karena itu, pengujian pada workload nyata menjadi langkah yang penting supaya konfigurasi akhir memberikan efisiensi tanpa mengorbankan hasil secara berlebihan.
Konfigurasi Batch dan Context Membantu Menjaga Efisiensi
Di samping parameter model, ukuran konteks memiliki pengaruh terhadap konsumsi sumber daya. Konteks dengan jumlah token lebih besar dapat membuat penggunaan VRAM bertambah seiring meningkatnya data yang harus dipertahankan. Ketika tugas tidak memerlukan riwayat yang terlalu luas, membatasi konteks sesuai kebutuhan dapat membuat penggunaan GPU lebih efisien.
Ukuran batch merupakan konfigurasi lain yang perlu disesuaikan. Batch yang terlalu besar dapat memberikan tekanan besar pada kapasitas GPU, sedangkan ukuran yang sangat rendah dapat mengurangi efisiensi pemrosesan. Penyesuaian batch sebaiknya dilakukan sedikit demi sedikit sembari membandingkan respons model dan utilisasi GPU. Strategi eksperimen seperti ini lebih efektif untuk menemukan konfigurasi optimal.
Optimalkan Software dan GPU Offloading untuk Mempercepat Inferensi
Performa AI lokal tidak hanya ditentukan oleh GPU. Lingkungan software, backend pemrosesan, driver, serta konfigurasi inferensi dapat memberikan perbedaan performa yang cukup besar. Runtime yang mendukung kemampuan komputasi perangkat secara tepat berpotensi meningkatkan throughput sekaligus menjaga penggunaan memory.
Pengguna dapat menentukan seberapa banyak bagian model yang diproses melalui kartu grafis. Jika VRAM mencukupi, porsi pemrosesan melalui GPU dapat ditingkatkan sehingga sebagian besar komputasi berat dapat ditangani GPU. Apabila kapasitas memory grafis tidak mencukupi, pembagian komputasi dapat dilakukan antara GPU dengan sistem utama, meskipun kecepatan inferensi dapat menurun. Menyesuaikan distribusi workload dapat membantu memperoleh performa terbaik dari perangkat yang tersedia.
Identifikasi Hambatan Sistem Sebelum Mengubah Hardware
Penyesuaian konfigurasi sebaiknya didasarkan pada hasil monitoring. Pemakaian kartu grafis, memory GPU, prosesor, memory sistem, suhu, dan throughput dapat dipantau selama workload berjalan. Informasi tersebut membantu pengguna menentukan komponen yang membatasi kecepatan.
Jika GPU memiliki utilisasi rendah tetapi CPU terus bekerja tinggi, workload mungkin masih terlalu bergantung pada CPU. Ketika konsumsi VRAM sangat tinggi, pengguna dapat memeriksa kembali precision, panjang konteks, cache, serta model. Temperatur yang terlalu tinggi dalam waktu lama berpotensi membuat kecepatan tidak stabil. Melalui monitoring sebelum melakukan perubahan, pengguna dapat melakukan optimasi pada bagian yang benar.
Kesimpulan
Mengoptimalkan GPU untuk AI lokal membutuhkan keseimbangan antara ukuran model, kapasitas VRAM, konfigurasi inferensi, dan kemampuan sistem. Pemilihan model yang sesuai, pengelolaan VRAM, quantization, pengaturan context, batch size, serta GPU offloading mampu meningkatkan efisiensi komputasi sambil menjaga penggunaan hardware tetap terkendali.
Monitoring tetap menjadi bagian penting dari seluruh proses karena kombinasi GPU, CPU, RAM, model, dan software tidak selalu sama. Perkembangan TEKNOLOGI AI lokal yang semakin cepat membuat optimasi sumber daya semakin relevan bagi pengguna. Melalui eksperimen terukur terhadap model dan pengaturan sistem, pengguna dapat memperoleh pengalaman inferensi yang lebih responsif dengan perangkat yang sudah dimiliki. Pembaca dapat membandingkan beberapa pengaturan untuk menemukan kombinasi terbaik bagi workload AI lokal masing masing.