Tips Menjalankan LLM Offline untuk Pemula, Cara Memilih Model AI Sesuai Kemampuan Laptop dan PC
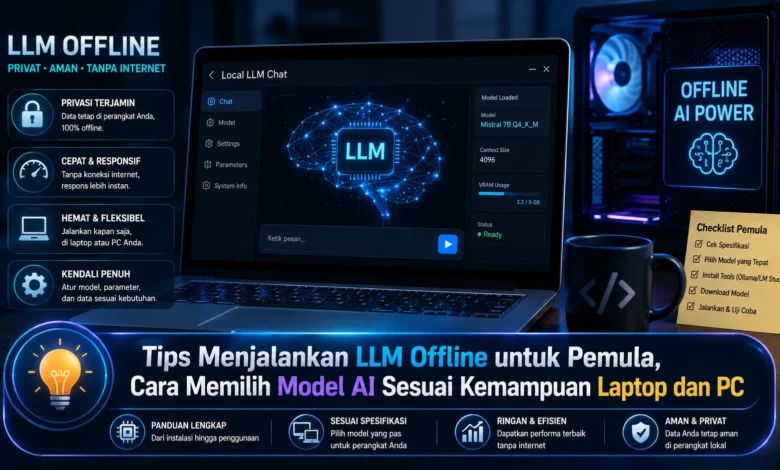
Menjalankan Large Language Model atau LLM langsung di laptop maupun PC kini semakin mudah dilakukan tanpa harus selalu mengandalkan layanan AI berbasis cloud. Bagi pemula, tantangan utamanya bukan sekadar memasang aplikasi, melainkan memilih model yang sesuai dengan kemampuan RAM, GPU, VRAM, prosesor, dan penyimpanan perangkat. Dengan memahami kebutuhan hardware dan karakter setiap model, TEKNOLOGI AI lokal dapat digunakan untuk menulis, merangkum dokumen, membantu pemrograman, hingga berbagai eksperimen secara lebih privat dan fleksibel.
Memahami Kemampuan Perangkat Menjadi Langkah Awal Menjalankan LLM Offline
Langkah pertama sebelum memasang model bahasa di komputer adalah mengetahui kapasitas hardware yang tersedia. Kapasitas memori, GPU dan VRAM, CPU, serta kapasitas storage akan memengaruhi ukuran model yang nyaman dijalankan. Semakin tinggi kebutuhan komputasi LLM, biasanya semakin banyak sumber daya yang diperlukan.
Jika baru mulai mencoba, model berukuran besar belum tentu menjadi pilihan terbaik. Model dengan kebutuhan memori moderat sering lebih mudah dijalankan karena waktu respons dapat lebih cepat. Tujuan utamanya adalah kesesuaian antara TEKNOLOGI AI dan hardware, bukan hanya memilih model terbesar.


Kapasitas Memori Membantu Menentukan LLM yang Cocok Digunakan
RAM dan VRAM menjadi dua faktor penting ketika menyiapkan inferensi di perangkat sendiri. Memori sistem dapat digunakan untuk menjalankan berbagai komponen inferensi, sementara VRAM menjadi sangat penting ketika pemrosesan menggunakan GPU. Ketika model terlalu berat, sistem dapat menjadi lambat.
Karena itu, pengguna sebaiknya memberikan cadangan memori bagi aplikasi lainnya. Komputer dengan kapasitas memori kecil dapat mencoba LLM ringan dengan kebutuhan memori rendah. Perangkat dengan kapasitas hardware lebih tinggi memiliki ruang lebih besar untuk LLM kompleks. Strategi seperti ini membantu mengurangi percobaan yang terlalu berat.
Jangan Hanya Melihat Besarnya Model ketika Memilih AI Lokal
Skala LLM memang memberikan gambaran mengenai kompleksitas model, tetapi belum tentu menentukan pengalaman terbaik. LLM kompak dengan arsitektur yang baik dapat memberikan hasil yang sangat berguna untuk tugas tertentu.
Dalam mencari AI lokal yang tepat, pertimbangkan tujuan penggunaan seperti mengolah bahasa, pemrograman, membuat ringkasan, atau chat sehari hari. Model khusus pengembangan software, misalnya, dapat lebih sesuai untuk pekerjaan teknis dibandingkan LLM yang lebih berorientasi percakapan. Pemilihan berdasarkan fungsi membuat TEKNOLOGI AI tidak sekadar menghabiskan sumber daya.
Kuantisasi Membuat AI Lokal Lebih Ramah untuk Laptop dan PC
Teknik pengurangan presisi model merupakan pendekatan populer bagi pengguna yang ingin menjalankan LLM secara lokal. Menggunakan pendekatan tersebut, representasi bobot model dapat dioptimalkan untuk mengurangi ukuran, sehingga model lebih mudah dimuat pada perangkat konsumen.
Namun, tingkat kuantisasi sebaiknya disesuaikan dengan kebutuhan karena pengurangan presisi yang sangat tinggi dapat membawa kompromi terhadap hasil. Pada tahap awal, format model yang masih mempertahankan kualitas memadai biasanya dapat memberikan pengalaman yang seimbang. Ketika sudah terbiasa, pengguna dapat mencoba konfigurasi lain.
CPU Tetap Bisa Menjalankan LLM tetapi GPU Membantu Mempercepat Inferensi
AI offline tidak selalu membutuhkan GPU khusus. Beberapa runtime dan format model memungkinkan model dijalankan melalui prosesor utama. Metode tersebut dapat menjadi pilihan untuk laptop standar, meskipun kecepatan respons dapat lebih rendah.
Apabila perangkat memiliki kartu grafis yang kompatibel, sebagian komputasi AI dapat dipindahkan ke GPU. Hasilnya, respons dapat terasa lebih lancar. Namun, memori GPU masih menjadi batas penting, sehingga GPU yang tersedia tidak otomatis cocok untuk semua LLM.
Pilih Runtime Lokal yang Mudah Digunakan dan Sesuai Workflow
Setelah mengetahui kemampuan hardware, langkah berikutnya adalah memilih runtime lokal. Perangkat lunak inferensi berfungsi untuk menjalankan file LLM serta memberikan cara berinteraksi dengan AI. Bagi pemula, aplikasi dengan konfigurasi yang tidak terlalu rumit dapat mempercepat proses belajar.
Pemula yang belum terbiasa dengan terminal dapat menggunakan runtime dengan antarmuka grafis. Sementara itu, pengguna teknis dapat menggunakan layanan dengan API lokal agar lebih mudah diintegrasikan. Pilihan terbaik bukan selalu yang memiliki fitur terbanyak, melainkan yang membuat LLM mudah dikelola.
Pengaturan Inferensi Membantu AI Lokal Berjalan Lebih Stabil
Ukuran model bukan satu satunya faktor dalam mengoptimalkan LLM offline. Jumlah informasi yang dipertahankan model juga dapat berpengaruh terhadap penggunaan sumber daya. Apabila percakapan menjadi semakin panjang, sistem dapat menggunakan sumber daya lebih besar.
Bagi pemula, gunakan context window sesuai kebutuhan dan hindari menjalankan terlalu banyak aplikasi berat secara bersamaan. Amati penggunaan RAM, VRAM, serta temperatur perangkat. Apabila respons menjadi sangat lambat, turunkan ukuran model hingga TEKNOLOGI AI dapat digunakan tanpa membebani perangkat secara berlebihan.
Kesimpulan, Memilih LLM Sesuai Hardware Membuat AI Lokal Lebih Nyaman
Mengoperasikan model bahasa di perangkat sendiri tidak harus membutuhkan perangkat paling mahal. Hal yang lebih penting adalah memahami kemampuan laptop atau PC, kemudian menentukan LLM secara realistis. Kapasitas memori, tingkat kuantisasi, serta runtime dan context window bersama sama memengaruhi performa AI lokal.
Bagi pemula, gunakan konfigurasi sederhana terlebih dahulu, kemudian lakukan eksperimen sesuai kemampuan hardware. Menurut Anda, apakah AI lokal akan semakin banyak digunakan seiring TEKNOLOGI komputasi lokal terus berkembang? Sampaikan pengalaman Anda mengenai cara memilih model AI dan ikuti informasi selanjutnya untuk mengetahui cara mengoptimalkan LLM.